Publicaste 0.10.0. Tus usuarios instalaron 0.9.0.
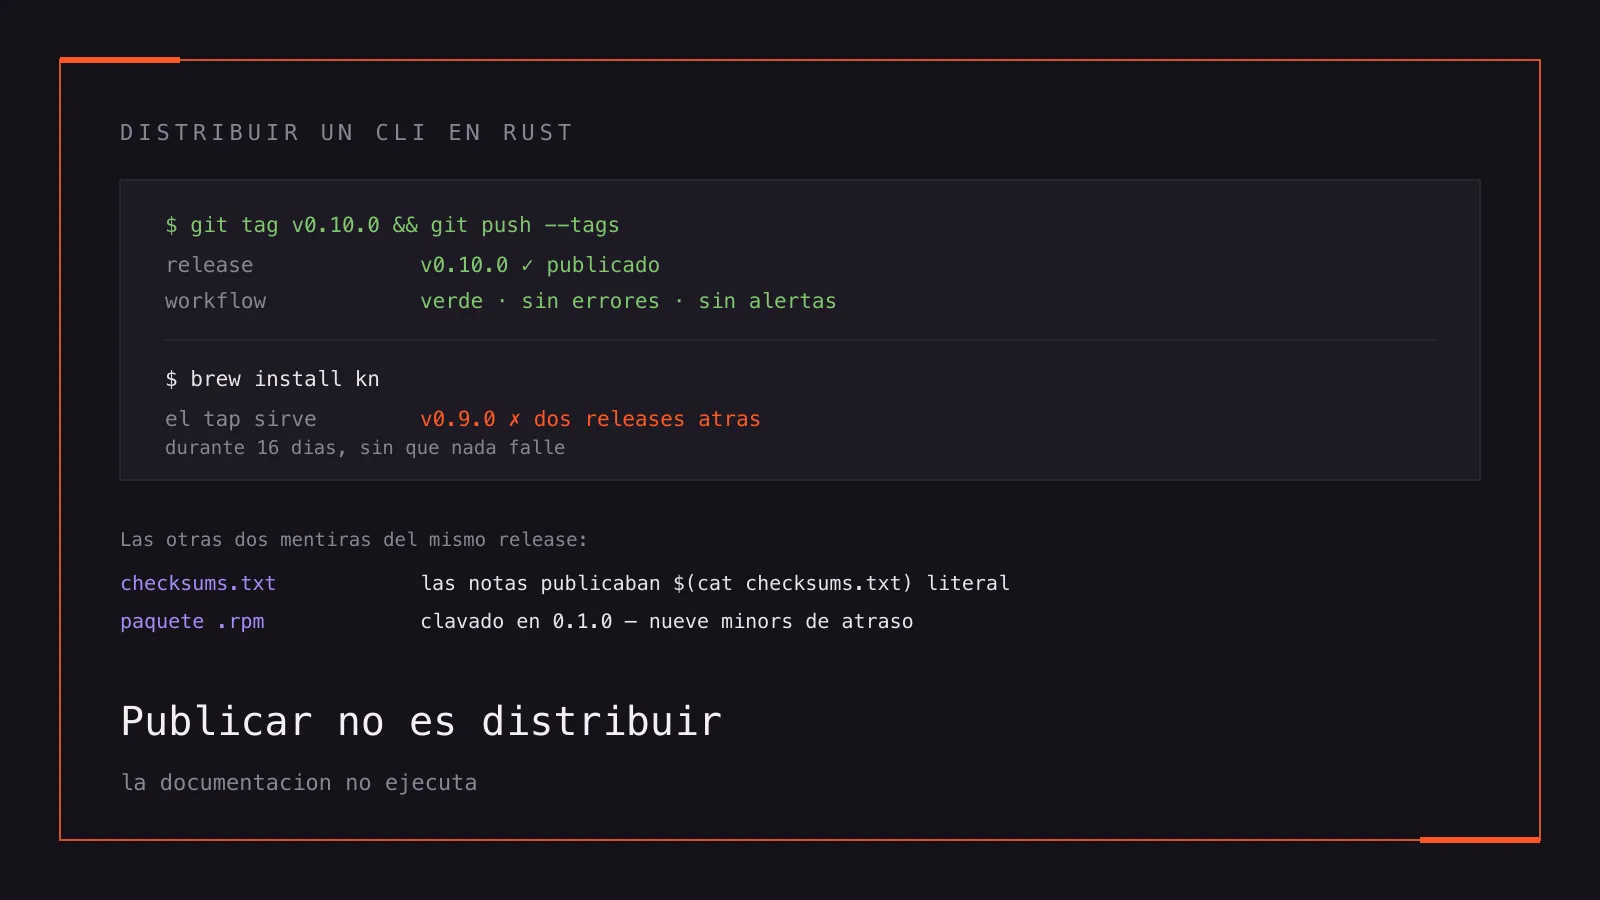
Publicaste 0.10.0. Tus usuarios instalaron 0.9.0.
La tesis
Publicar y distribuir no son lo mismo, y la diferencia es cara.
Publicar es un hecho verificable: el tag existe, el binario está subido, el
workflow terminó en verde. Distribuir es lo que efectivamente le llega a
alguien cuando escribe brew install — y eso no lo decide el release, lo
decide una fórmula, un script o un paquete que vive en otro lado y que puede
estar mintiendo desde hace semanas sin que nada falle.
kn es una CLI en Rust que mantengo, y el 1 de agosto publiqué la 0.10.0.
Durante dieciséis días, hasta la 0.11.0 del 17, brew install kobogithub/knowledge/kn siguió entregando 0.9.0. Ningún workflow en rojo,
ningún error, ninguna alerta. El release estaba perfecto. Lo que estaba mal era
todo lo que venía después.
Este post es sobre cómo se arregló, y sobre por qué la distribución necesita su propio CI.
Tres formas de mentir sin fallar
Cuando fui a mirar, no era un problema: eran tres, y los tres tenían la misma forma.
1. El tap servía dos releases atrás. La fórmula de Homebrew vive en un repositorio aparte, y actualizarla era un paso escrito en el documento de release. Un paso escrito es un paso que alguien tiene que acordarse de hacer, y en la 0.10.0 no me acordé.
2. Las release notes nunca tuvieron los checksums. El template los armaba
con un heredoc entrecomillado, para que los backticks de la prosa sobrevivieran
literales. Efecto colateral: $(cat checksums.txt) también sobrevivió literal.
Todas las releases hasta la v0.10.0 publicaron esto:
## Checksums

```
$(cat checksums.txt)
```
Eso sigue ahí, en la v0.10.0, como monumento.
Un checksum que no verifica nada es peor que no publicar ninguno: promete una garantía que no está dando.
3. El .rpm estaba clavado en Version: 0.1.0 mientras el proyecto iba en
0.10.0. Nueve versiones menores de atraso, sin producir un paquete actual
desde hacía mucho.
Las tres comparten diagnóstico. Nada se rompió, porque no había nada corriendo que pudiera romperse: un paso documentado en vez de automatizado, y un artefacto que nadie ejercitaba.
La documentación no ejecuta.
Antes de automatizar, recortar
La reacción intuitiva al tercer punto es arreglar el .rpm. Hice lo contrario:
lo borré, junto con el .deb, junto con Windows, junto con los Mac Intel.
El release construía tres artefactos y dos no los instalaba nadie. Que la receta de RPM llevara nueve minors de atraso no era un descuido — era el dato. Si hubiera estado en uso, alguien habría avisado en la primera versión, no en la novena. Mantenerla viva era pagar el costo de un canal que solo existía en el README.
kn pasó a soportar macOS en Apple Silicon y nada más. Es un breaking
change, y va en la posición menor porque el proyecto está abajo de 1.0 y esa es
la convención pre-1.0. La versión anterior sigue descargable para quien esté en
otra plataforma.
Un canal de distribución que nadie ejercita no está soportado: está declarado. La diferencia se descubre el día que alguien lo usa.
El tap que se actualiza solo
Con un solo artefacto, el trabajo pasó a ser que la fórmula no pueda quedarse atrás. Es un job más en el workflow de release, y las decisiones interesantes no son que exista, sino cómo está armado.
Los checksums salen de los bytes que se publicaron. El job baja el artefacto desde la URL del release y lo hashea ahí mismo. No lee un valor guardado en el repositorio, porque un checksum mantenido a mano es exactamente el drift que este job vino a eliminar.
curl -fsSL -o binary.tar.gz "${base}/releases/download/${VERSION}/kn-macos-arm64.tar.gz"
curl -fsSL -o source.tar.gz "${base}/archive/refs/tags/${VERSION}.tar.gz"
needs: [create-release] es la compuerta. Un job con needs corre solo si
todo lo que necesita terminó bien, así que un build fallido deja el tap
intacto, apuntando a la última versión que sí funciona. Una fórmula que apunta
a un release inexistente es peor que una vieja: la vieja instala.
Es idempotente. Volver a correr el release de un tag existente no puede dejar una edición a medias ni un commit vacío. Si la fórmula renderizada ya coincide con la publicada, el job se va sin tocar nada.
Y cuenta las sustituciones. El render es un re.subn sobre la fórmula del
repositorio, que funciona como plantilla. Un regex que dejó de matchear no
falla solo: devuelve el texto intacto y sigue de largo, que es como se publica
una fórmula con la versión vieja y el checksum nuevo.
if (n1, n2, n3) != (1, 1, 2):
    sys.exit(f"unexpected substitution counts: url={n1} resource={n2} sha256={n3}")
Después verifica. El último paso lee el raw del tap ya publicado y falla si no sirve la versión que se acaba de sacar. No confía en que el push haya hecho lo que pensaba.
Por qué además hay un chequeo semanal
Con esa verificación al final del release uno diría que alcanza. No alcanza, y la razón me parece la parte más útil de todo esto.
Una aserción adentro del pipeline solo puede observar el momento en que corre. No ve un push que después se revierte. No ve un token que expira tres meses más tarde, cuando ya nadie está mirando. No ve una fórmula editada a mano con buenas intenciones. Toda esa clase de divergencia aparece después de que el job dijo que sí.
Así que hay un segundo workflow, deliberadamente independiente, que corre por cron los lunes y contesta una sola pregunta: ¿el tap publica la versión más nueva que este repositorio sacó?
Dos decisiones ahí valen más que el chequeo en sí.
Archiva un issue en vez de confiar en el mail. Un workflow programado que falla depende de que el dueño del repositorio tenga las notificaciones de Actions activadas — un setting de la cuenta que el workflow no puede ver ni garantizar. Un issue aparece en el repositorio, haya notificaciones o no. Y reusa el issue abierto en vez de crear uno nuevo cada lunes.
El cuerpo del issue dice qué no hacer:
Do not fix this with a manual copy into the tap — that is the failure
mode the automation replaced. Fix the pipeline.
Sin esa línea, el arreglo obvio a las tres de la tarde es copiar la fórmula a mano. Funciona, cierra el issue, y reintroduce exactamente el problema.
Lo que solo aparece cuando alguien instala de verdad
El resto de lo que aprendí no sale de diseñar el pipeline, sale de que la cosa se instale en una máquina que no es la mía.
La fórmula no puede declarar su versión. brew audit --strict rechaza una
línea version como redundante cuando la URL ya trae el tag. Consecuencia poco
obvia: para saber qué versión publica el tap hay que parsear la URL. Los dos
workflows lo hacen, y por eso el formato de esa URL es load-bearing.
Homebrew aísla $HOME durante el install. La fórmula no puede escribir en
~/.kn/ aunque quiera, así que ese paso vive en un caveats con los comandos
listos para copiar. Descubrirlo lleva un rato, porque no falla: simplemente no
pasa nada.
Las instalaciones rivales son un clásico y no las ve nadie. Si alguien usó
el instalador por curl tiene un kn en ~/.local/bin, y si después hace brew install tiene otro en el prefijo de Homebrew. Cuál corre depende del orden del
PATH, y el síntoma es un kn --version desconcertantemente viejo. La fórmula
revisa las rutas conocidas y, si encuentra otra copia, nombra las dos, dice
cuál va a ganar y da el comando para borrar la que sobra.
El test de la fórmula no corre el comando de diagnóstico. Lo hacía, y estaba roto para cualquiera sin las herramientas opcionales instaladas: el comando sale con código distinto de cero cuando falta alguna, y en el entorno de test de Homebrew faltan hasta Rust y Cargo. Ahora afirma sobre lo que la fórmula instala —que el binario responde, que los skills y los agentes aterrizaron—, que es lo único sobre lo que un test de fórmula tiene autoridad.
Un test tiene que afirmar sobre lo que su unidad produce, no sobre lo que la máquina que lo corre tiene puesto.
Y la sonda de Rosetta, mi favorita. Bajo un shell traducido (arch -x86_64), una Mac Apple Silicon reporta x86_64. Un instalador que
rechaza todo lo que no sea arm64 rechazaría justo las máquinas que apunta. La
sonda mira sysctl.proc_translated y resuelve el caso:
if [[ "$ARCH" == "x86_64" ]]; then
    rosetta_flag=$(sysctl -n sysctl.proc_translated 2>/dev/null || echo 0)
    if [[ "$rosetta_flag" == "1" ]]; then
        ARCH="arm64"   # Apple Silicon bajo traducción
    fi
fi
El chequeo de plataforma además corre antes de cualquier request de red, así que una máquina no soportada recibe un mensaje que explica qué pasa, en vez de un 404 sobre un artefacto que no se construye.
El estado hoy
Desde la 0.11.0 el tap no se volvió a atrasar, y las tres corridas semanales del chequeo cerraron en verde. Las release notes traen los checksums de verdad. El código está todo a la vista: kobogithub/knowledge y el tap en kobogithub/homebrew-knowledge.
Lo que me llevo
- La distribución necesita su propio CI. El pipeline que construye el binario y el que garantiza que la gente lo reciba son dos cosas, y la segunda suele no existir.
- Derivá los checksums de los bytes publicados. Cualquier valor que se mantenga a mano en dos lugares va a divergir; la única pregunta es cuándo.
- Contá las sustituciones. Un regex que dejó de matchear no te avisa: te devuelve el texto intacto y el pipeline sigue en verde.
- Un chequeo que corre dentro del pipeline no puede ver lo que pasa después. Si te importa un invariante, verificalo con algo que corra en otro momento y por otro motivo.
- Preferí un artefacto que se instala a tres que se declaran. Un canal sin uso no se mantiene solo: se pudre en silencio y te enterás el día que alguien confía en él.
Nada de esto es sobre Rust, ni sobre Homebrew. Es sobre que entre “lo publiqué” y “lo tienen” hay un montón de sistema, y ese sistema también se rompe. Solo que se rompe callado.