Dos planos que se mueven a distinta velocidad
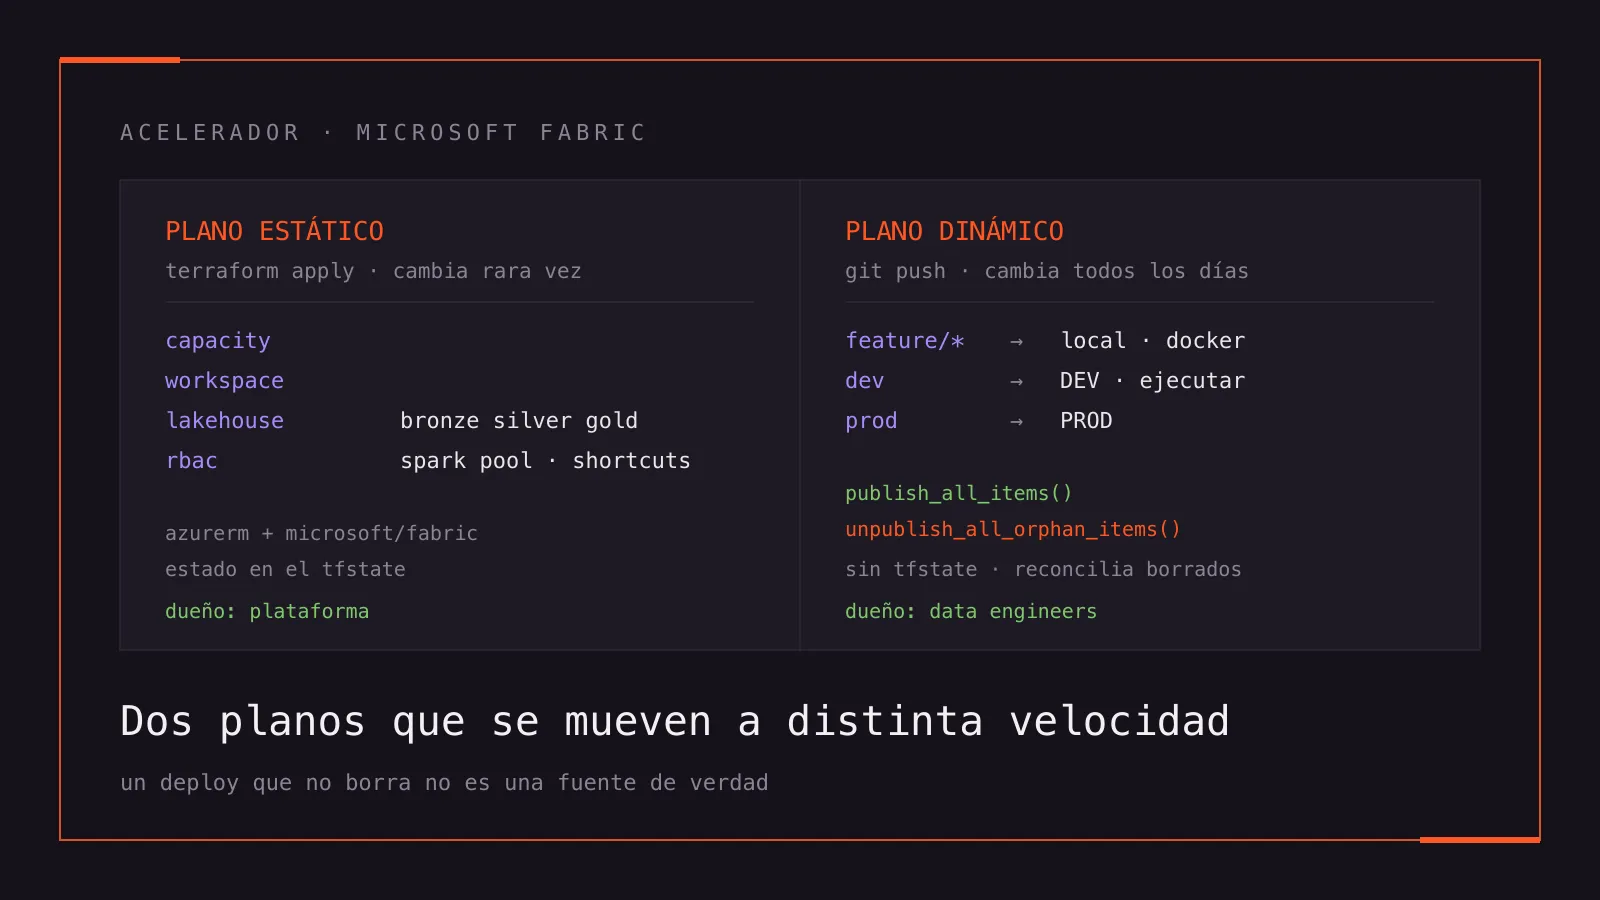
Dos planos que se mueven a distinta velocidad
La tesis
Una plataforma de datos no es una cosa que se despliega. Son dos, y tratarlas como una sola es el error que después se paga en cada release.
Lo aprendí armando un acelerador para Microsoft Fabric: el repositorio que un equipo copia el día uno de un proyecto y del que salen, sin decisiones pendientes, la capacity, el workspace, los lakehouses medallón, los permisos, el CI/CD y un entorno de desarrollo local. La idea del acelerador es que nadie vuelva a discutir cómo se llama un lakehouse ni cómo se promueve un notebook a producción.
La primera versión intentaba manejarlo todo con Terraform. Funcionaba perfecto. Hasta que apareció el primer notebook.
Este post es sobre esa fractura, sobre las tecnologías que terminó usando cada lado, y sobre un puñado de cosas que Fabric no te dice hasta que te las choca.
Así quedó al final, con los dos planos uno al lado del otro y el mismo destino abajo:
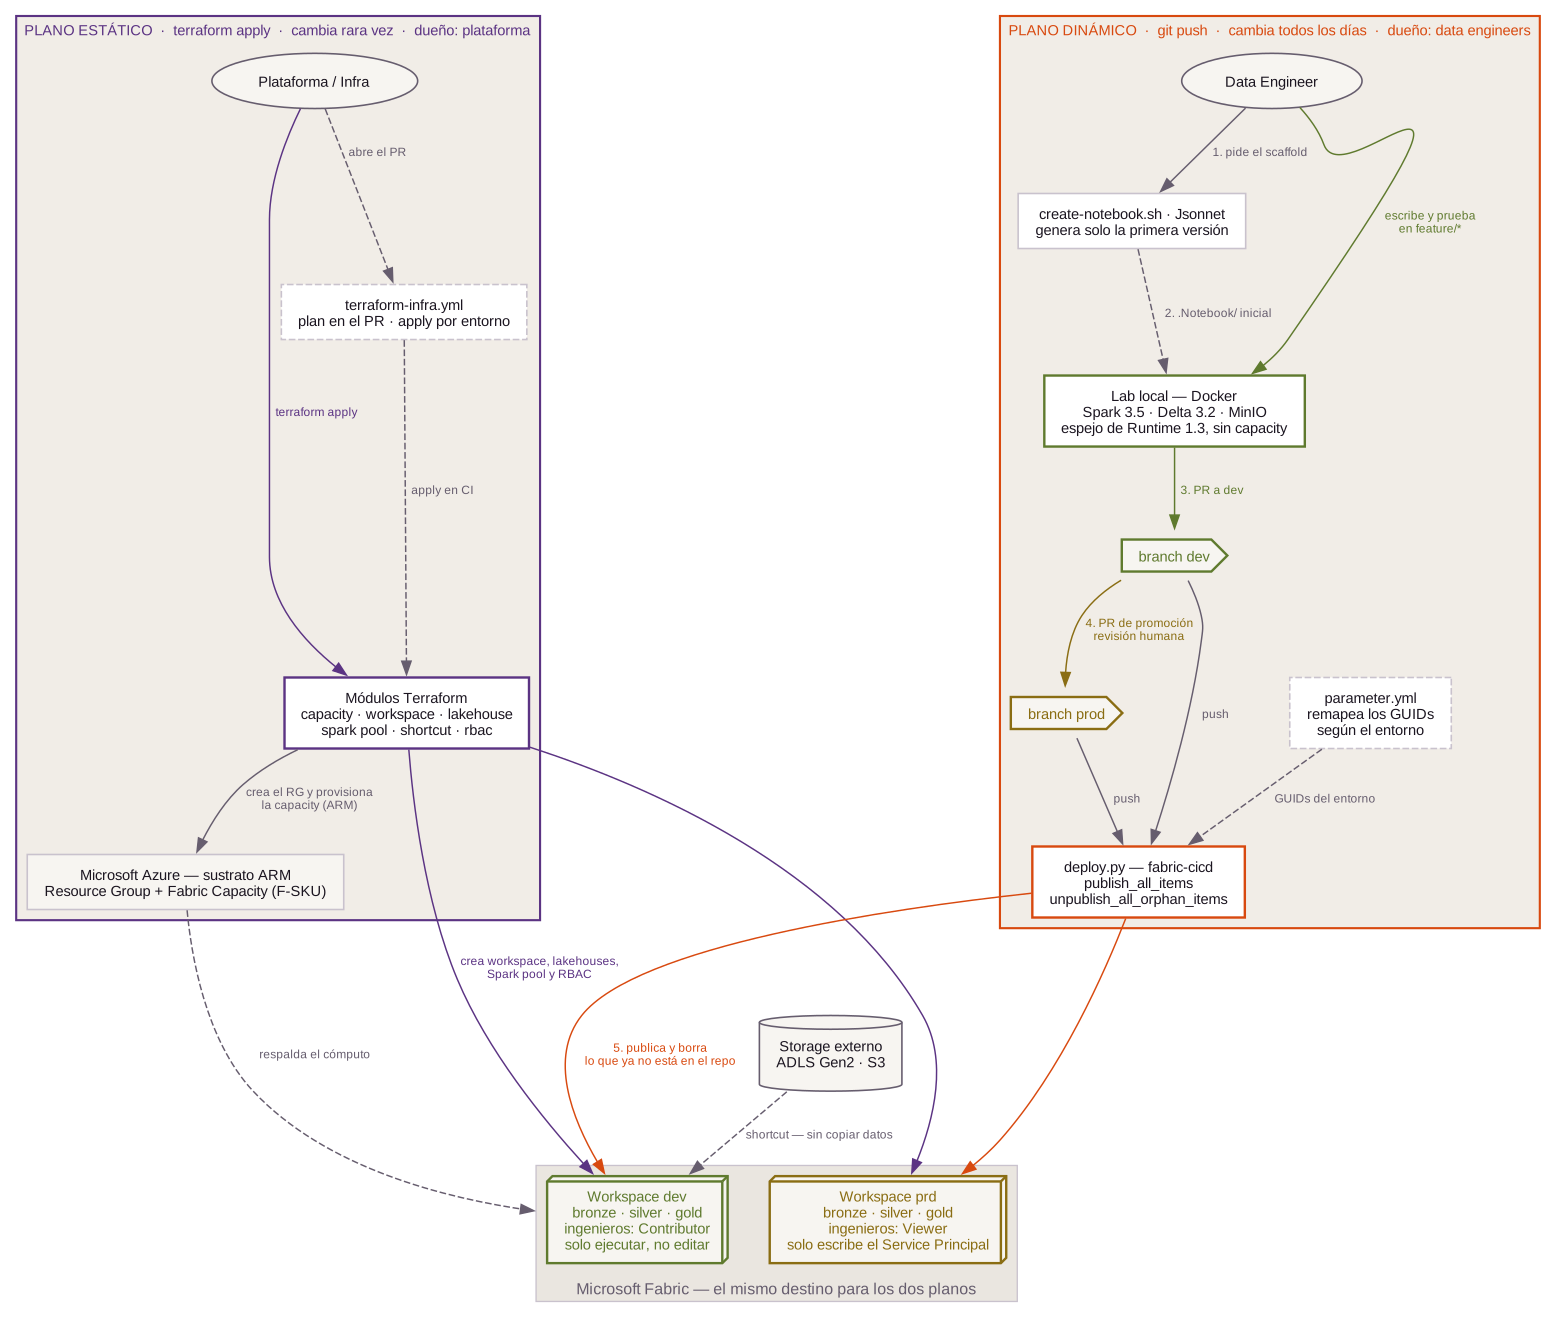
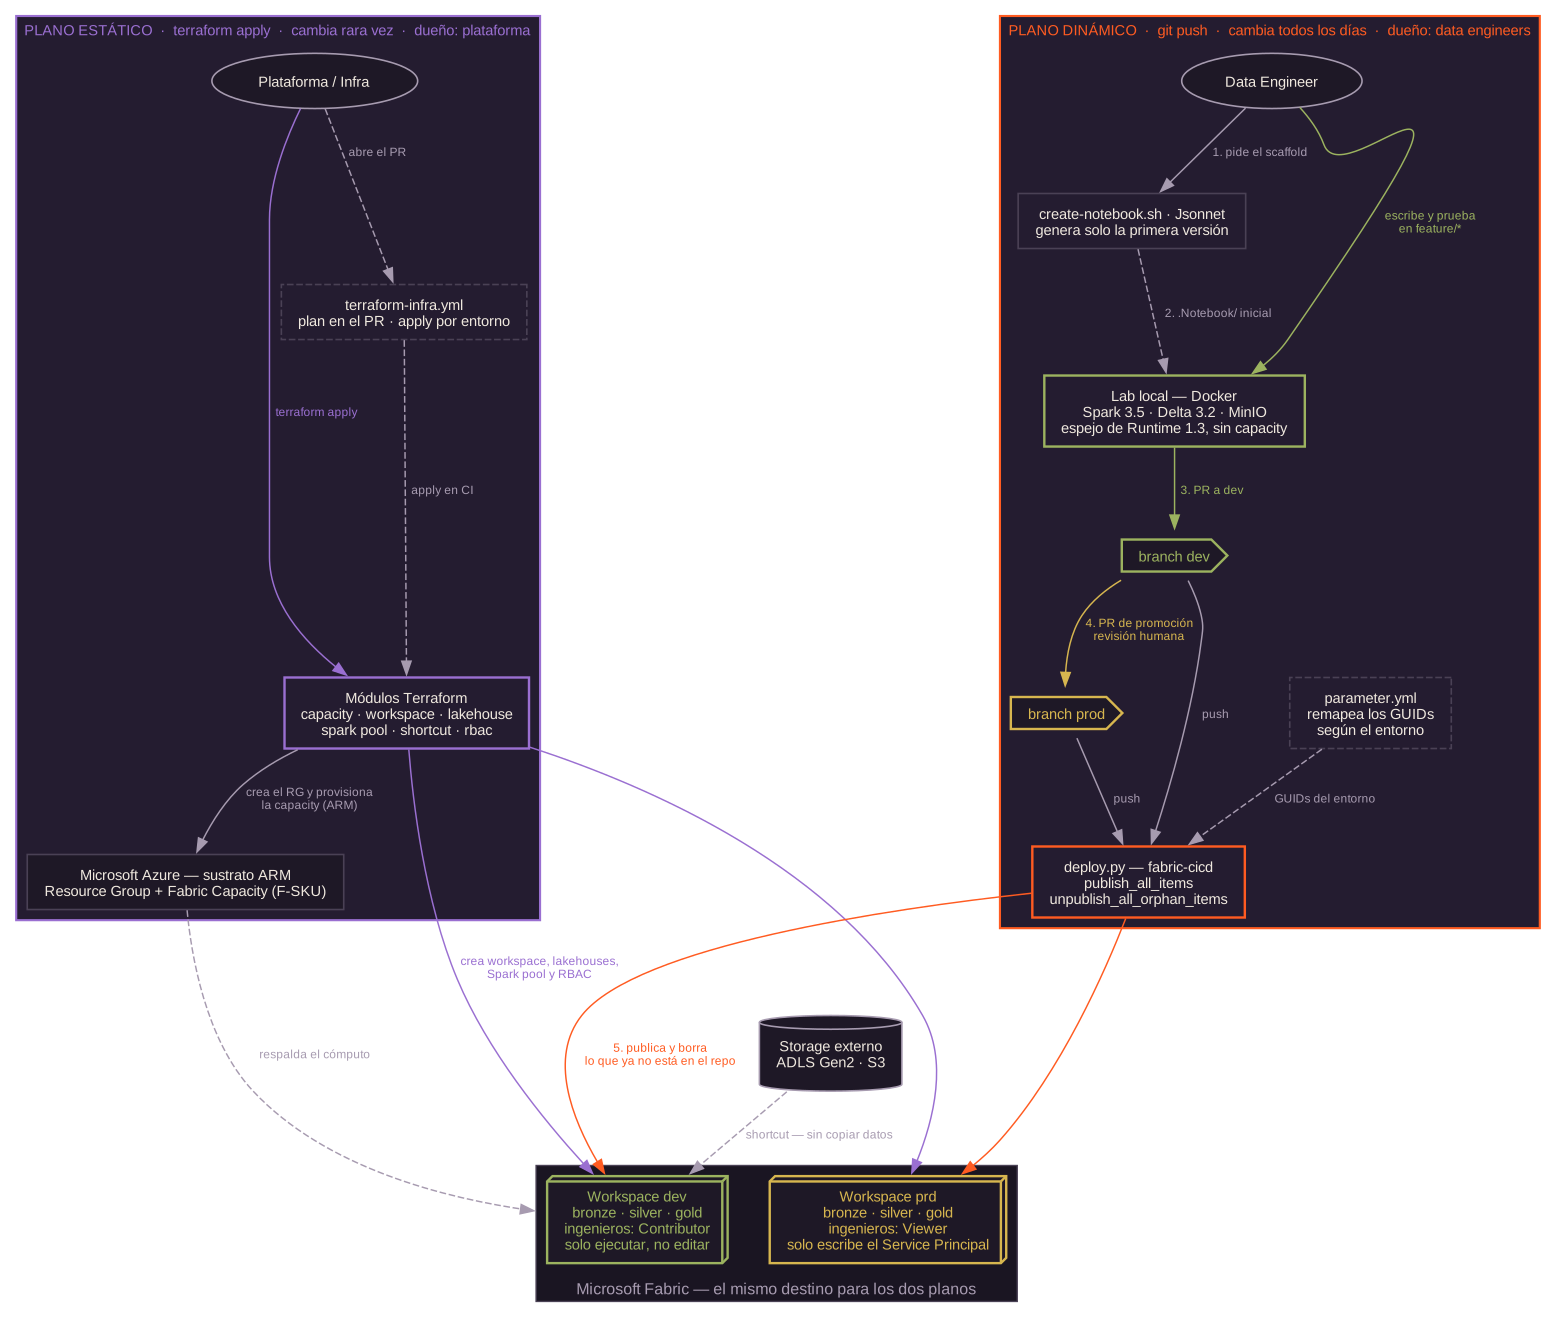
architecture/fabric-dos-planos/.El plano estático: dos providers, porque Fabric está partido al medio
Lo que se aprovisiona una vez y cambia poco es Terraform, sin discusión: resource group, capacity, workspace, los tres lakehouses medallón, el Spark pool, el environment, los shortcuts a storage externo y el RBAC.
La primera sorpresa es que hacen falta dos providers a la vez:
| Provider | Gestiona |
|---|---|
hashicorp/azurerm | Resource Group + Fabric Capacity — son recursos ARM de Azure |
microsoft/fabric | Workspace, lakehouses, environment, Spark, RBAC — viven dentro de Fabric, con su propia API y sus propios GUID |
No es una preferencia de diseño: la capacity la factura Azure y la gobierna ARM, mientras que todo lo que vive adentro del workspace lo gobierna la API de Fabric, con identificadores que no son el resource ID de ARM. El módulo de capacity termina resolviendo el GUID interno con un data source y pasándoselo al workspace, que es el pegamento entre los dos mundos.
De ahí sale un gotcha que me costó una tarde. Quería una sola composición raíz
con un flag create_capacity = false para los tenants donde la capacity ya
existe. No alcanza:
Error: building account: could not acquire access token to parse claims:
AADSTS90002: Tenant '...' not found. ... this may happen if there are no
active subscriptions for the tenant
  with provider["registry.terraform.io/hashicorp/azurerm"]
El provider azurerm pide un token de management.azure.com en el momento
de configurarse, aunque todos sus recursos estén en count = 0. Terraform
no poda un provider declarado. Con lo cual, en un tenant de pruebas sin
suscripción de Azure —un Fabric Trial, por ejemplo—, la composición falla
antes de planear una sola línea.
Un provider no es una dependencia perezosa. Se configura porque está declarado, no porque lo uses.
La solución fue tener dos composiciones raíz que crean exactamente los mismos
recursos de Fabric y difieren solo en si declaran azurerm o no.
Dos rarezas más del provider
El lakehouse rechaza guiones. dev-miempresa-lakehouse-bronze devuelve un
InvalidParameter opaco, y el workspace con el mismo patrón se crea sin
problema. La razón es que el displayName del lakehouse funciona además como
identificador SQL de su endpoint, así que hay que derivar
dev_miempresa_lakehouse_bronze. Es específico del lakehouse: workspace,
environment y Spark pool aceptan guiones sin chistar.
El techo real de executors es uno menos del que parece. Fabric reserva un
nodo del pool para el driver, así que el máximo de executors dinámicos tiene
que ser autoscale_max_nodes - 1. Si te pasás, el error no llega en el plan:
llega a mitad del apply, con el workspace a medio construir. Terminó como
una lifecycle.precondition sobre el recurso del pool.
Cada validación que podés mover de apply-time a plan-time se paga sola la primera vez que alguien la choca.
Por qué un notebook no va en el tfstate
Ahora el otro lado. Un data engineer crea notebooks todo el tiempo, los edita todos los días y no le pide permiso a nadie de infraestructura para hacerlo.
Terraform es excelente para lo que tiene estado y cambia poco. Un notebook
tiene exactamente la propiedad inversa: su contenido cambia constantemente y
mantener eso en un .tfstate significa que cada línea de PySpark pasa por un
terraform apply. El repo todavía tiene el módulo que intentó eso, marcado
como deprecado, para que nadie lo redescubra creyendo que es una buena idea.
El segundo intento fue un CLI imperativo: un import que empuja los notebooks
al workspace. Publica bien. El problema es lo que no hace: si borrás un
notebook del repo, en el workspace sigue vivo. Y ahí “el repositorio es la
fuente de verdad” deja de ser cierto, en silencio, la primera vez que alguien
borra algo.
La diferencia entre un deploy y una sincronización es si borra.
El tercer intento es el que quedó: fabric-cicd, la librería de Microsoft para deploy declarativo. Dos llamadas:
publish_all_items(workspace)          # crea y actualiza lo que está en el repo
unpublish_all_orphan_items(workspace) # borra en el workspace lo que ya no está
La segunda línea es la que convierte el repo en fuente de verdad. Todo lo demás del plano dinámico se apoya en ella.
GitOps de tres escalones
Con eso resuelto, el modelo quedó así:
feature/*   →   local      Docker: Spark + Delta + MinIO. Autoría y prueba.
                           No toca Fabric. No consume capacity.
    │
    ▼ PR
  dev       →   DEV        Deploy automático. Solo EJECUCIÓN, no edición.
                           Ingenieros: Contributor.
    │
    ▼ PR (revisión humana)
  prod      →   PROD       Mismo workflow, mismo script, otro workspace.
                           Ingenieros: Viewer. Solo escribe el Service Principal.
Los dos entornos son destino del mismo script y del mismo workflow. Lo único que cambia es el par (entorno, workspace), y se deriva de la rama en un único lugar:
case "${{ github.ref_name }}" in
  dev)  environment=DEV;  workspace_id="$DEV_WORKSPACE_ID" ;;
  prod) environment=PROD; workspace_id="$PRD_WORKSPACE_ID" ;;
  *)    echo "::error::rama sin entorno asociado"; exit 1 ;;
esac

[ -n "$workspace_id" ] || { echo "::error::falta el secret"; exit 1; }
Ese exit 1 de la última línea no es paranoia. Los notebooks referencian su
lakehouse por GUID, y un archivo de parámetros remapea esos GUID según el
entorno durante el publish. Si el par se desalinea —entorno DEV apuntando al
workspace de producción, por ejemplo—, fabric-cicd publica sin remapear
nada y los notebooks de un entorno quedan leyendo el lakehouse del otro.
Fabric no se queja: una referencia entre workspaces es perfectamente válida
para la plataforma. El error se descubre semanas después, mirando datos que no
cierran.
La función que decidimos no usar
Fabric trae Git Integration: sincronización bidireccional entre un workspace y una rama. El ingeniero edita en la UI y Fabric commitea de vuelta al repo. Suena a lo que uno quiere.
La descartamos, y fue una de las mejores decisiones del proyecto. Con Git Integration activa en un workspace que además recibe deploys, hay dos escritores compitiendo por el mismo estado: el ingeniero desde la UI y el pipeline desde la rama. No hay forma de que “el repo es la única verdad” y “la UI escribe al repo” convivan sin que alguien pierda cambios.
El beneficio inesperado fue de superficie de seguridad. Git Integration necesita un PAT de GitHub guardado como Connection en Fabric, y un tenant setting específico habilitado. Los dos requisitos existen porque en ese modelo Fabric es el cliente que llama a la API de GitHub. En el modelo de deploy es al revés —GitHub Actions llama a Fabric— y la única credencial es el Service Principal que ya usaba Terraform.
Cada integración bidireccional que sacás te devuelve una credencial que ya no tenés que rotar.
El módulo de Terraform que la configura sigue en el repo, funcional y sin usar, documentado como referencia. Un acelerador tiene que poder mostrar el camino que no tomó.
El escalón que más se usa es el que no toca la nube
Si tuviera que quedarme con una sola pieza del acelerador, sería esta, y es la
menos glamorosa: un docker-compose.yml que replica el runtime de Fabric en la
máquina.
minio          # stand-in de OneLake / ADLS: S3-compatible, bronze/silver/gold
               # como carpetas de un bucket
spark-master   # apache/spark:3.5.3
spark-worker
jupyter        # delta-spark 3.2.0 + hadoop-aws para hablar s3a con MinIO
Las versiones no son casuales: Fabric Runtime 1.3 es Apache Spark 3.5 +
Delta Lake 3.2. El lab clava esas dos y se abre con Dev Containers, así que
el ciclo entero es code . → Reopen in Container.
El cálculo es simple. Iterar un notebook contra Fabric real es un ciclo de minutos que además consume capacity —o sea, plata—. En local es de segundos y es gratis. Para el 90 % de lo que hacés mientras escribís un pipe —sintaxis, transformaciones, probar un merge de Delta contra una muestra chica— no necesitás la nube.
Y es importante ser honesto sobre dónde termina el espejo: no hay OneLake, no hay shortcuts, no hay SQL endpoint, no hay V-Order. Lo que se prueba en local es la lógica; el pipe terminado se valida en DEV contra Fabric real.
Un espejo local no tiene que ser fiel. Tiene que ser fiel en lo que iterás.
Lo que la plataforma no te deja expresar
Yo quería una regla concreta: en DEV los ingenieros ejecutan notebooks, pero no los editan. Ejecutar es necesario —hay que validar contra datos reales—; editar rompe el modelo, porque la fuente de verdad es el repo.
No existe. Los roles de workspace de Fabric ponen “ejecutar o cancelar un notebook” y “escribir o borrar un notebook” en el mismo escalón: Admin, Member y Contributor tienen las dos; Viewer no tiene ninguna, y un Viewer tampoco puede ejecutar. No hay rol intermedio, y no lo hay porque la matriz de permisos no fue diseñada para esa distinción.
La salida no fue insistir con los permisos, fue llegar a la misma política por
otro camino. Como cada deploy corre unpublish_all_orphan_items, cualquier
cosa editada a mano en la UI desaparece en el push siguiente. La garantía
no viene del permiso: viene de que el mecanismo la vuelve inútil.
Cuando la plataforma no puede expresar tu política, no la escribas en un documento. Hacela una consecuencia del mecanismo.
En producción sí están las dos cosas: Viewer por permiso, y reconciliación
por si acaso.
Las fallas que no fallan
Revisando el repo terminado me di cuenta de que casi todos los guardas que escribí protegen contra el mismo tipo de error: el que no da error.
- El par (entorno, workspace) desalineado publica al lakehouse equivocado, y Fabric lo acepta.
- Los notebooks guardan el nombre del lakehouse además del GUID. Fabric
resuelve por GUID, así que si el nombre no se remapea nada se rompe — pero
un notebook de producción muestra
dev_...en la UI y en los mensajes de error, y el próximo diagnóstico arranca torcido. - El repo guarda los nombres de ítem sin prefijo de entorno; el prefijo lo
agrega el deploy según la rama. Si alguien commitea uno, se publicaría
dev-dev-..., y la rama de producción publicaría un ítem llamadodev-.... - Renombrar un ítem ya publicado no es un update: fabric-cicd busca por
(displayName, type), no lo encuentra, crea uno nuevo, y el orphan cleanup borra el viejo. Con notebooks el efecto es solo esa rotación; con un ítem con estado, no.
Cada uno de esos casos terminó siendo un exit 1 explícito con un mensaje que
dice qué archivo tocar. Un job que falla en treinta segundos es infinitamente
más barato que un dato mal calculado durante tres semanas.
El stack completo, y por qué cada pieza
| Pieza | Rol |
|---|---|
Terraform + azurerm + microsoft/fabric | Plano estático. Módulos por recurso, composiciones por caso de capacity. |
| fabric-cicd (Python) | Plano dinámico. Publicación declarativa con reconciliación de borrados. |
| Jsonnet | Scaffolding del notebook: esqueleto medallón + metadata del ítem, con la nomenclatura correcta. |
| GitHub Actions | Los dos planos: plan en el PR y apply por entorno; deploy de notebooks por rama. |
| Docker + Dev Containers | El lab local espejo de Runtime 1.3. |
| Spark 3.5 · Delta 3.2 · MinIO | El contenido de ese lab. |
| LikeC4 | El diagrama de arquitectura, como código validado en CI. |
| checkov · trivy | Escaneo de seguridad de la IaC. |
Dos elecciones que merecen una línea propia.
Jsonnet genera la primera versión y nunca más. La tentación de que un generador sea el dueño permanente del archivo es fuerte y es una trampa: el día que el ingeniero escribe la lógica de negocio, el generador y el archivo divergen, y volver a correrlo destruye trabajo. El scaffold garantiza que el punto de partida sea consistente; a partir de ahí el dueño es la persona.
LikeC4 en vez de un PNG. El diagrama de arquitectura es texto, vive al lado del código que describe y se valida en CI. Un PNG en un drive compartido tiene una fecha de vencimiento que nadie escribe pero todos conocen.
Lo que me llevo
- Separá por velocidad de cambio, no por tecnología. Las dos preguntas son ¿quién es el dueño de este cambio? y ¿cada cuánto cambia?. Si las respuestas difieren, son dos planos, y forzarlos al mismo mecanismo va a doler en los dos.
- Un deploy que no borra no es una fuente de verdad. Es un import con buena prensa.
- Mové las validaciones al plan. Un error a mitad del apply deja el sistema en un estado que nadie diseñó.
- Si la plataforma no expresa tu política, buscá el mecanismo que la haga inevitable. Escribirla en la documentación no cuenta.
- Las fallas silenciosas son el trabajo. Lo que se rompe ruidosamente ya está resuelto: alguien lo ve y lo arregla. Lo que hay que diseñar es lo que funciona mal sin avisar.
El acelerador está listo para el proyecto que venga. Pero lo que me llevo no es el repo: es que la primera pregunta frente a cualquier plataforma no es qué herramienta usar, sino cuántas cosas distintas estoy tratando como una sola.