Lakehouse Medallion on-premise
ActivoUn lakehouse completo que corre entero en una laptop: Bronze, Silver y Gold con tests y linaje, sin depender de ninguna nube. Sirve para aprender la arquitectura y para probar transformaciones antes de llevarlas a producción.
- Rol
- Autor
- Período
- 2026
El problema
Aprender o evaluar una arquitectura lakehouse normalmente arranca con una cuenta cloud, un cluster que cuesta por hora y una factura que crece mientras experimentás. Eso vuelve caro equivocarse, que es justamente lo que hay que poder hacer mientras aprendés.
El mismo problema aparece en el trabajo diario: para probar si una transformación funciona no debería hacer falta ocupar un entorno compartido ni esperar a que se libere.
La solución
Un lakehouse medallion reproducible al 100% en local, levantado con Docker Compose. Cada pieza cloud se reemplaza por un equivalente que corre en la máquina, manteniendo las mismas interfaces:
| Rol | En la nube | Acá |
|---|---|---|
| Object storage | S3 / ADLS | MinIO (S3-compatible) |
| Motor de consulta | Spark / Snowflake | DuckDB |
| Formato de tabla | Delta / Iceberg | Apache Iceberg |
| Orquestación | Airflow gestionado | Apache Airflow |
| Transformación | dbt | dbt |
Que MinIO hable el protocolo de S3 es lo que hace que el ejercicio valga: el código que lee y escribe no sabe que no está en la nube, así que lo que aprendés y lo que probás se traslada.
Arquitectura medallion
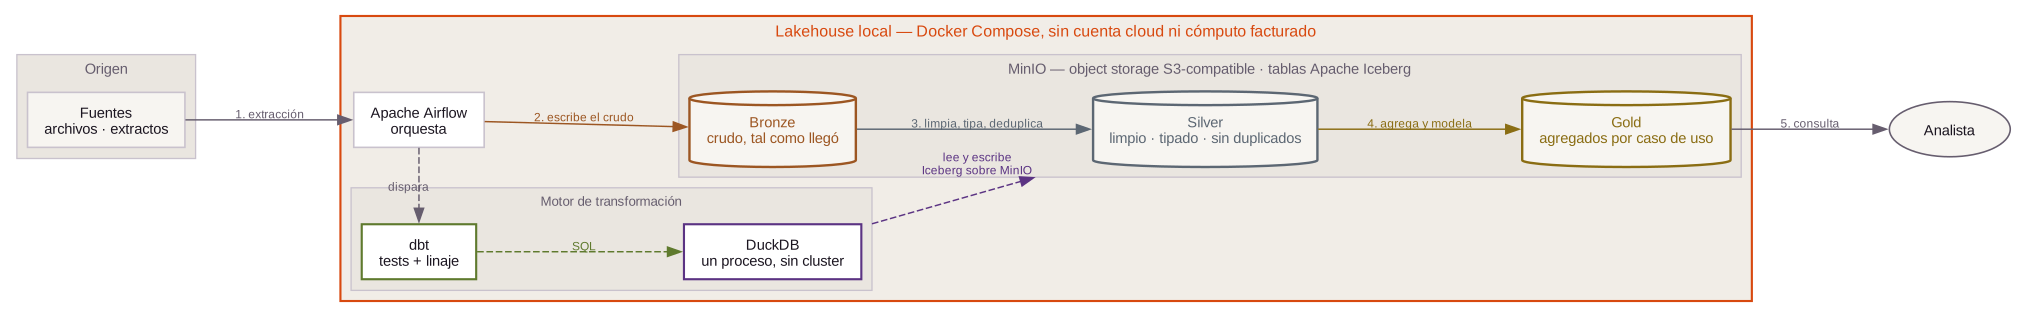
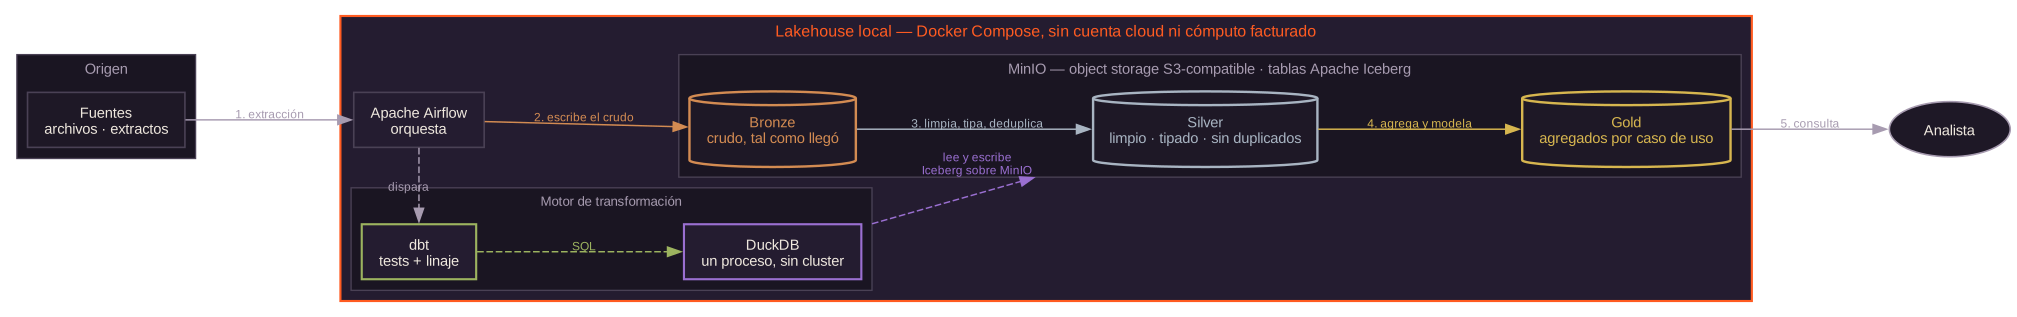
architecture/lakehouse-medallion/.El flujo sigue las tres capas clásicas:
Bronze — ingesta cruda, tal como llegó. Sin limpiar, sin tipar, sin deduplicar. Es el registro de lo que efectivamente entró, y permite reprocesar todo si más adelante cambia una regla.
Silver — datos limpios, tipados y conformados. Acá se resuelven duplicados, se normalizan formatos y se aplican las reglas de calidad.
Gold — modelos listos para consumo, agregados y orientados al caso de uso.
dbt maneja las transformaciones de Silver hacia Gold de forma declarativa, con tests sobre las suposiciones que importan y linaje derivado automáticamente de las dependencias entre modelos. Airflow orquesta el conjunto.
Por qué DuckDB
Para volúmenes que entran en una máquina, DuckDB hace el trabajo de un motor distribuido sin el costo operativo de serlo. No hay cluster que dimensionar, ni tiempo de arranque, ni coordinación entre nodos: es un proceso que lee Parquet e Iceberg y responde.
El límite es real y conviene decirlo — esto no reemplaza Spark cuando los datos no entran en una laptop. Pero una porción grande del trabajo de data engineering ocurre por debajo de ese umbral, y ahí la complejidad distribuida se paga sin recibir nada a cambio.
Qué resuelve en la práctica
- Iterar sin costo. Probar una transformación, romperla, volver atrás y repetir sin consumir cómputo facturado.
- Reproducibilidad. El entorno entero está declarado; se levanta igual en cualquier máquina.
- Enseñar la arquitectura. El medallion se entiende mucho mejor cuando se puede ver cada capa y romperla a mano.
Estado
En desarrollo. Es la contraparte local de las arquitecturas medallion que corren en producción sobre Databricks y AWS.