Ni el owner del proyecto puede leer esa columna
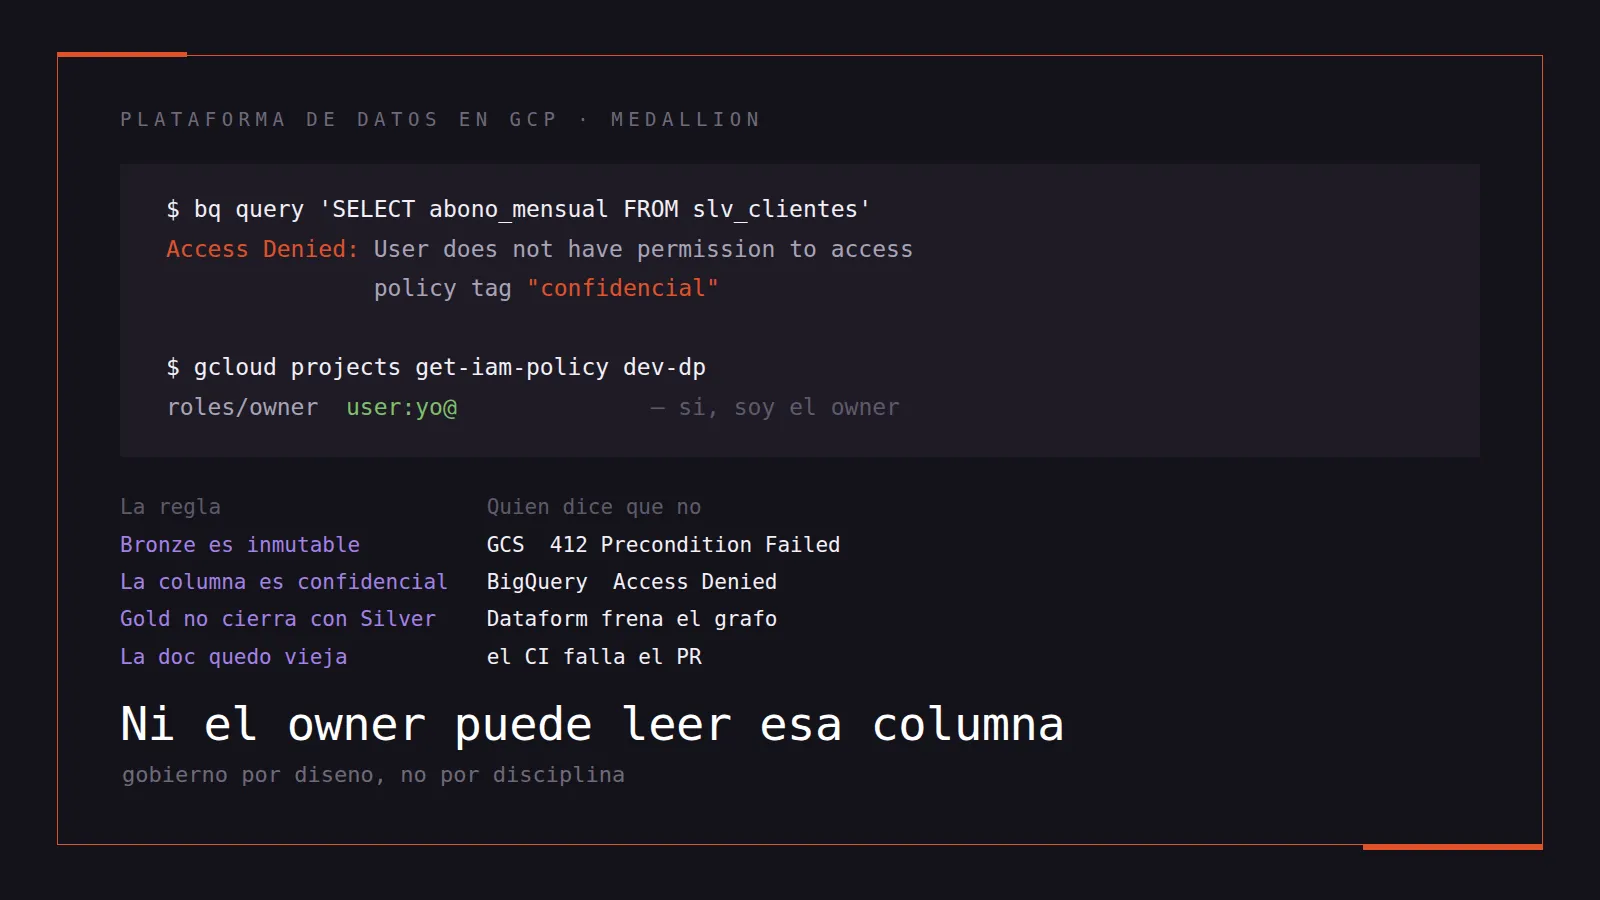
Ni el owner del proyecto puede leer esa columna
La tesis
El problema de una organización chica o mediana con sus datos casi nunca es el volumen. Es que la lógica de negocio vive dispersa en scripts de la herramienta de BI: sin versionar, sin tests, sin linaje. De ahí salen cuatro síntomas que siempre aparecen juntos:
- Nadie puede rastrear un número de un tablero hasta su origen.
- Las fallas son silenciosas: un tablero sirve datos viejos durante meses sin disparar un error.
- No hay catálogo, glosario ni dueños, y el control sobre el dato sensible es la buena fe de quien arma el tablero.
- La ingesta pisa el histórico y pierde filas por paginación mal resuelta.
Los cuatro tienen la misma forma. Existe una regla que todo el mundo suscribe, y no existe nada que la haga cumplir.
“Bronze no se sobrescribe” es un acuerdo. “El tablero solo lee Gold” es un acuerdo. “La columna de facturación no la ve cualquiera” es un acuerdo. Un acuerdo se sostiene hasta el martes que alguien está apurado.
Así que armé una plataforma de datos sobre GCP —Medallion, Terraform, Dataform— con una sola pregunta de diseño repetida por cada regla que me importaba: ¿quién dice que no, y qué pasa cuando alguien lo intenta igual?
Las dos versiones de cada regla
| Regla | La versión por disciplina | Quién dice que no |
|---|---|---|
| Bronze es inmutable | “el extractor hace append” | GCS rechaza el PUT con un 412 |
| El tablero solo lee Gold | permisos que alguien puso una vez | La service account de BI no tiene grant sobre Silver |
| Esta columna es confidencial | un comentario en el modelo | BigQuery: Access Denied on policy tag |
| Gold no publica un número que no cierra | alguien revisa antes del comité | Dataform no construye lo que depende de la assertion que falló |
| La documentación está al día | buena voluntad | El CI falla el PR |
La columna del medio es lo que casi todos los repos tienen. La de la derecha es el trabajo.
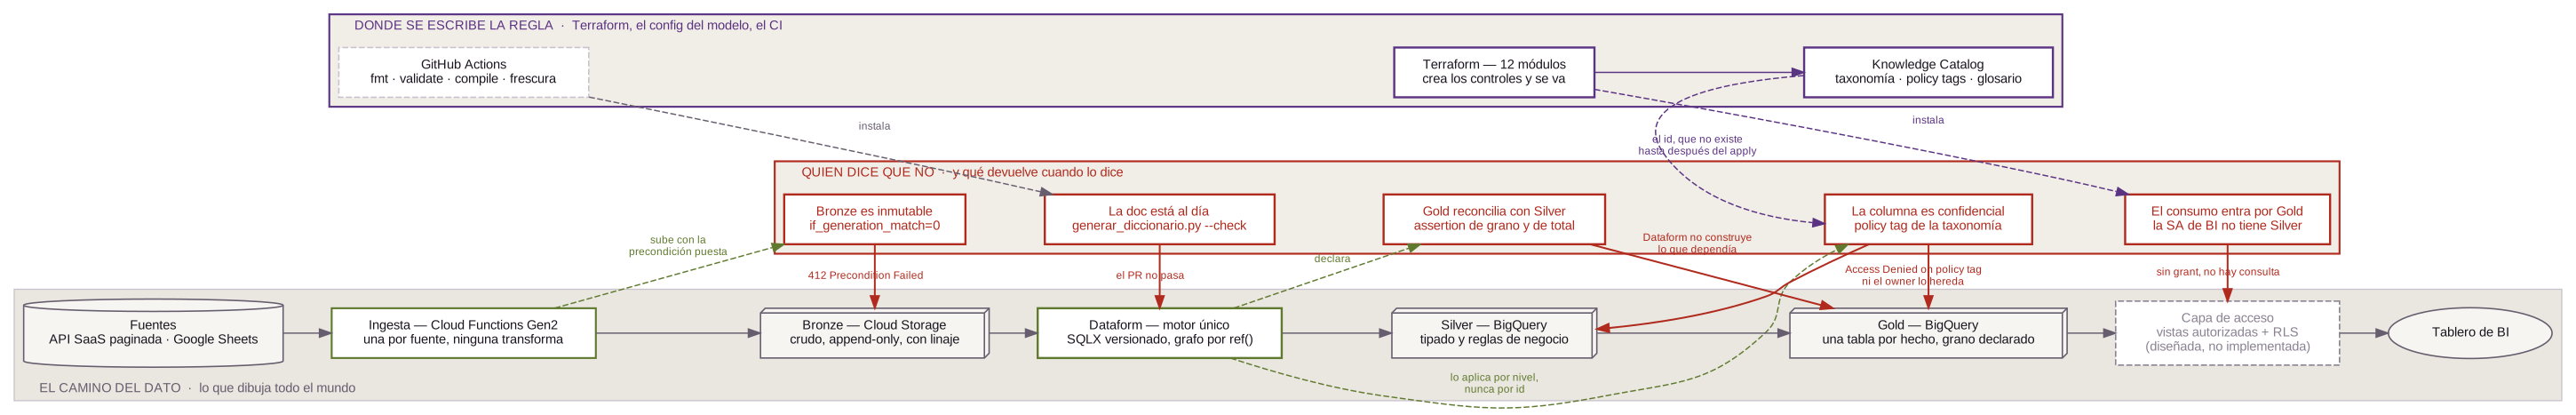
architecture/gcp-data-platform/.El caso más incómodo: el control por columna
Hay dos mecanismos en GCP que se parecen y no compiten. Confundirlos es el error más común que vi.
Label data_sensitivity | Policy tag | |
|---|---|---|
| Se aplica a | el recurso (dataset, bucket) | la columna |
| Sirve para | inventariar, atribuir costo, buscar | impedir la lectura |
| Quién lo aplica | Terraform | Dataform, en el config del modelo |
| Si no tenés acceso | igual leés todo | Access Denied on policy tag |
El label responde qué recursos tocan dato sensible. Es una etiqueta de inventario: sirve para desglosar costo en el billing export y para responder “quién es el dueño de esto” sin leer Terraform. No impide nada.
El policy tag responde quién puede leer esta columna, y la respuesta la aplica BigQuery en tiempo de consulta.
Lo que sorprende la primera vez es que el policy tag no se hereda del IAM del
proyecto. Sin un binding explícito de datacatalog.categoryFineGrainedReader
sobre ese nivel de la taxonomía, nadie lee esa columna. Ni el owner del proyecto.
Parece un default agresivo y es el único correcto: el acceso al dato sensible se otorga, no se hereda. Por eso el mapa de lectores arranca vacío:
readers_por_nivel = {} # a propósitoUna taxonomía que nace con todo el mundo adentro no clasifica nada.
La consecuencia hay que decirla antes de aplicarla: la primera vez, algún
tablero va a fallar. Una consulta que venía andando empieza a devolver
Access Denied on policy tag. Eso no es un bug del módulo. Es la primera vez que
alguien tiene que decidir si esa service account debería ver esa columna —y
dejarla afuera también es una respuesta válida.
El id que no existe hasta después del apply
Acá aparece una costura que me gustó resolver.
El policy tag lo crea Terraform. Lo aplica Dataform, en el config del
modelo. Pero el id del tag no existe hasta después del apply, y cambia en cada
ambiente. Escribirlo en el .sqlx haría que el proyecto no compile en un
ambiente nuevo.
Entonces viaja como var de compilación, de Terraform a Dataform:
// dataform/includes/constantes.js
const POLICY_TAGS = {
  restringido:  dataform.projectConfig.vars.policy_tag_restringido  || "",
  confidencial: dataform.projectConfig.vars.policy_tag_confidencial || "",
};

function sensibilidad(nivel) {
  const tag = POLICY_TAGS[nivel];
  if (tag === undefined) {
    throw new Error(`Nivel de sensibilidad desconocido: ${nivel}`);
  }
  return tag ? [tag] : [];
}
Y el modelo nombra el nivel, nunca el id:
abono_mensual: {
  description: "Abono recurrente en NUMERIC.",
  bigqueryPolicyTags: constantes.sensibilidad("confidencial")
}
El detalle que importa es el || "". Vacío es un estado válido: mientras el
catálogo no esté aplicado, los modelos compilan y no etiquetan nada. La
tentación es la contraria —poner un id de mentira para que “ande en local”— y es
la peor opción disponible, porque un policy tag inexistente no falla en la
compilación: falla en el apply contra BigQuery, y para entonces ya está
mergeado.
Es la misma forma del problema del que escribí ayer: el error existe desde el principio, y lo único que se elige es en qué momento aparece. Un id falso lo mueve del lugar donde molesta al lugar donde duele.
Bronze no se pisa porque el storage no deja
El anti-patrón que motiva la capa Bronze es if_exists='replace': el extractor
corre, pisa lo de ayer, y el histórico deja de ser reconstruible sin que nadie se
entere.
La versión por disciplina de la solución es “los extractores hacen append”. La versión que se sostiene sola son dos barreras para la misma regla:
blob.upload_from_string(
    json.dumps({"_lineage": lineage, "records": records}, ensure_ascii=False),
    content_type="application/json",
    if_generation_match=0,
)
Primero, el nombre del objeto es único —timestamp más uuid— así que dos
corridas no colisionan. Segundo, if_generation_match=0 le dice a GCS que la
subida solo es válida si el objeto no existe; si existe, la API devuelve
412 Precondition Failed y la función explota.
La segunda parece redundante mientras la primera funcione. El día que el generador de nombres tenga un bug, el nombre único deja de ser único y la precondición es lo único que separa “perdimos un día de histórico” de una excepción en los logs. La inmutabilidad la garantiza el storage, no la disciplina de quien programó el extractor.
El número que no cierra no llega al tablero
gld_presupuesto_vs_real agrega gld_ingresos_mensuales por segmento. Un join
puede mentir de dos maneras: filtrando de más (perdés filas) o multiplicando
(duplicás). Las dos producen un número perfectamente plausible en un tablero, y
ninguna produce un error.
La assertion compara los dos totales, mes a mes:
FROM detalle
FULL OUTER JOIN agregado ON detalle.mes = agregado.mes
WHERE ABS(COALESCE(detalle.total, 0) - COALESCE(agregado.total, 0)) > 0.01
Dos decisiones adentro de esas tres líneas. La comparación es por mes y no
global, porque un total global puede coincidir por compensación entre dos meses
con errores de signo opuesto. Y la tolerancia de 0.01 es por redondeo de
NUMERIC, no un margen de error de negocio: si algún día hace falta subirla, el
problema no es la tolerancia.
Lo que la convierte en un control y no en un log es qué hace Dataform cuando falla: no construye lo que depende de ese modelo. El pipeline se frena antes de Gold en vez de publicar un número malo y avisar en un canal que nadie mira.
Lo que sí se genera, y lo que no
El diccionario de datos sale de los config de los .sqlx. Describir dos veces
lo mismo garantiza que una de las dos versiones esté mal:
python3 scripts/generar_diccionario.py --check # falla si quedó viejoEse --check corre en el CI. Si un modelo cambia y nadie regeneró el
diccionario, el PR no pasa. Las mismas descripciones son las que Dataform publica
en BigQuery y las que después levanta el catálogo: una fuente, tres destinos.
El glosario de negocio, en cambio, se escribe a mano —y eso es lo correcto.
El diccionario describe lo que el código hace; el glosario describe lo que el
negocio decidió. Una columna llamada ingreso_recurrente puede estar
perfectamente documentada y seguir sin resolver si un contrato pausado suma o no
suma. Eso no se puede derivar del SQL, porque el SQL es la consecuencia de la
decisión, no la decisión.
Por eso cada término lleva quién lo firma. Un término sin dueño es una opinión, y a los seis meses nadie se acuerda de cuál era.
Ahí está el límite del método: automatizar corre la frontera de lo que no puede quedar viejo, no la borra.
Cuando la convención pierde
Un caso donde la regla se chocó con un límite ajeno. El project ID por
convención es {environment}-{client}-{project}-gcp. Los account_id de las
service accounts derivan de ahí, y GCP los limita a 30 caracteres. No entran.
Había dos salidas: acortar la convención en todos lados, o admitir que GCP tiene la última palabra. Elegí lo segundo, con una condición: que el que se lo lleve por delante no tenga que averiguar nada.
validation {
  # El rol más largo es "dataform" (8). 30 - len("-sa-dataform") = 18.
  condition     = length("${var.sa_prefix}-sa-dataform") <= 30
  error_message = "sa_prefix demasiado largo: supera los 30 caracteres que GCP permite en un account_id. Definí `gcp_project_id_override` en el terraform.tfvars del ambiente."
}
Falla en el plan, antes de tocar nada, y el mensaje dice qué escribir. La
versión por disciplina de esto era un párrafo en CONVENTIONS.md explicando el
límite, que se lee el día que ya rompiste algo.
Lo que todavía no está
Conviene ser explícito, porque la mitad de lo que conté arriba es diseño validado, no producción:
- El módulo de catálogo compila y valida contra el provider, pero nunca se aplicó contra un proyecto real. Lo del policy tag que ni el owner puede leer es cómo está documentado que funciona, no una anécdota mía de un incidente.
- Bronze todavía no aterriza en BigQuery: los conectores dejan JSON en GCS y falta la tabla externa o el load job.
- Los dos conectores son de referencia, sin probar contra una API real.
- Row-level security y vistas autorizadas están en el modelo C4 y no en Terraform.
workflowyschedulerestán escritos y no instanciados en ningún ambiente.
El día que esto se aplique contra un proyecto de verdad, la parte que espero que duela es la de los policy tags. Que duela es el punto: significa que había alguien leyendo una columna que nunca decidimos que pudiera leer.
Lo que me llevo
- Una regla que depende de disciplina no es una regla, es una intención. La pregunta útil no es “¿está documentado?” sino “¿qué pasa si alguien lo hace igual?”.
- El control que sirve es el que te puede decir que no a vos. Un policy tag que el owner del proyecto no puede saltear vale más que cualquier permiso que se hereda hacia abajo.
- Elegí dónde aparece el error. Nunca elegís si el error existe; solo si
aparece en tu ambiente o en el
applyde producción. Un id inventado para que compile en local es esa elección, hecha mal. - Generá todo lo que se pueda, y aceptá lo que no. La documentación generada no puede quedar vieja; la escrita a mano sí. Lo que decide el negocio no está en el código, y pretender lo contrario produce un glosario que miente.
- Cuando la convención choca con un límite ajeno, no documentes el límite.
Hacé que el
planfalle con el mensaje que dice qué hacer.
Nada de esto es específico de GCP. Terraform, Dataform y BigQuery son el vocabulario; el ejercicio es ir regla por regla decidiendo si vive en un documento o en un mecanismo. Cada una que se muda cuesta más ese día y deja de costar todos los demás.