pip escribió ERROR y salió con código 0
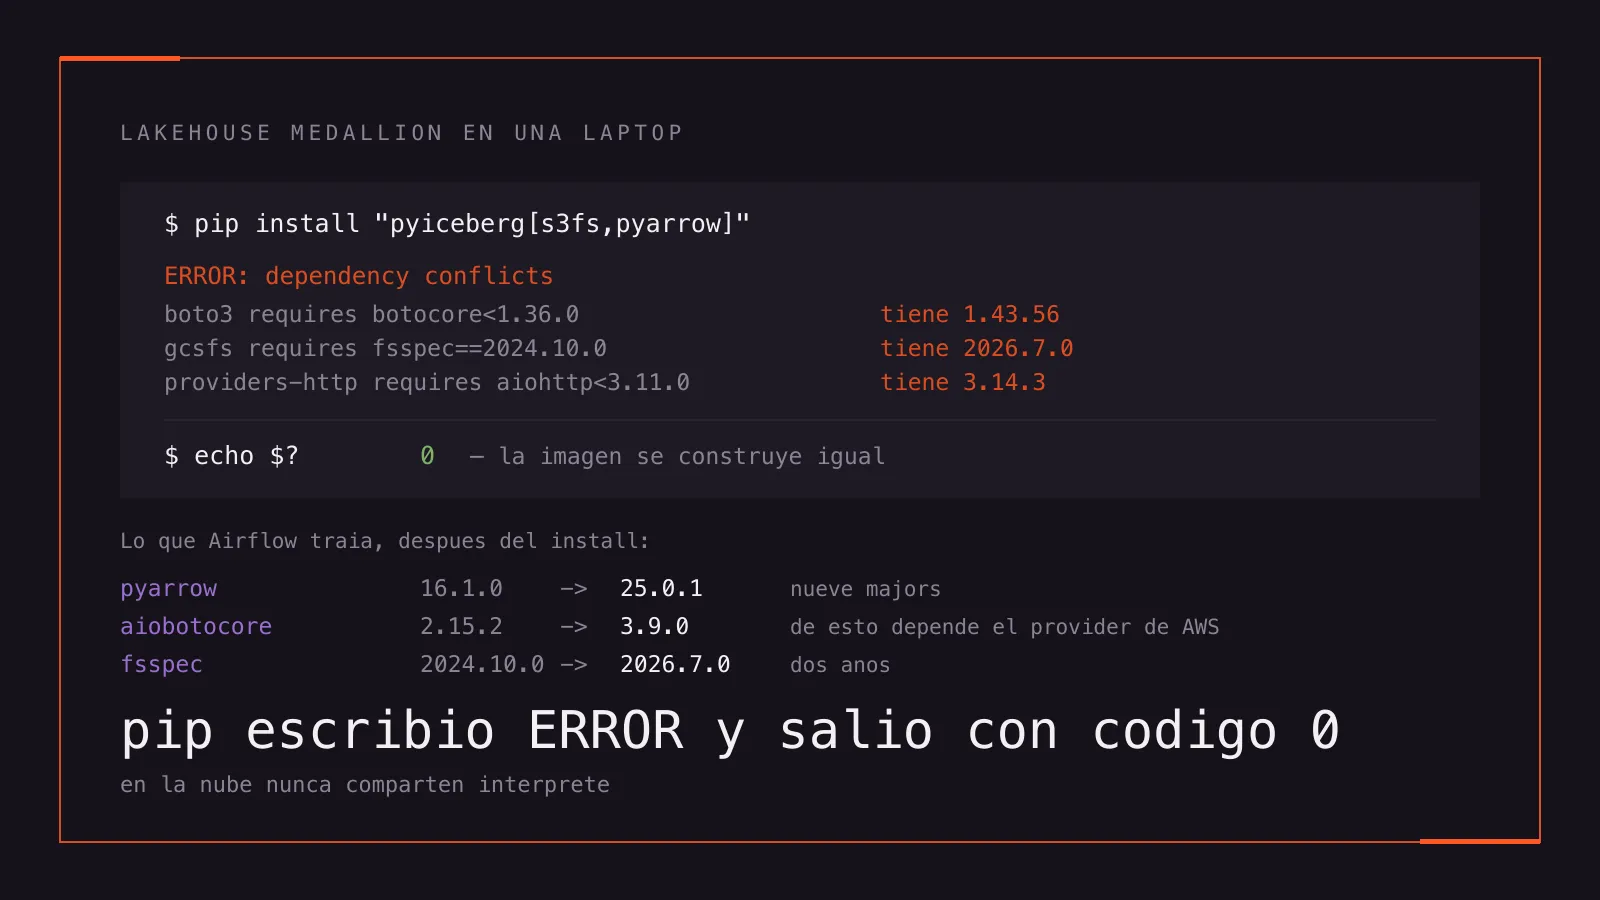
pip escribió ERROR y salió con código 0
La tesis
Un lakehouse que corre entero en tu laptop se vende como la versión barata de uno en la nube. Mismas capas, mismas interfaces, sin factura. Y en buena medida es cierto: el cómputo alcanza, el almacenamiento alcanza, el modelo mental se traslada.
Lo que no se traslada es el aislamiento.
En la nube, el orquestador y el motor que escribe tus tablas son dos servicios gestionados. Corren en máquinas distintas, en runtimes distintos, con resolvedores de dependencias distintos. Nunca se ven. Ese aislamiento no lo diseñaste: viene incluido, y por eso no aparece en ningún diagrama.
Cuando bajás el stack a una sola máquina, ese regalo se termina. Y el
mecanismo que administra lo que queda —pip— puede violar tres restricciones
declaradas, imprimir la palabra ERROR tres veces, y salir con código 0.
El stack
Un lakehouse medallion clásico, Bronze → Silver → Gold, con cada pieza cloud reemplazada por un equivalente que corre en la máquina y habla el mismo protocolo:
| Rol | En la nube | Acá |
|---|---|---|
| Object storage | S3 / ADLS | MinIO (S3-compatible) |
| Motor de consulta | Spark / Snowflake | DuckDB |
| Formato de tabla | Delta / Iceberg | Apache Iceberg |
| Catálogo | Glue / Unity | Lakekeeper (REST) |
| Orquestación | Airflow gestionado | Apache Airflow |
| Transformación | dbt | dbt |
Que MinIO hable S3 es lo que hace que el ejercicio valga la pena: el código que lee y escribe no sabe que no está en la nube. dbt materializa Silver y Gold como parquet externo directo al object storage —
{{ config(materialized='external', location='s3://silver/int_ventas_limpias.parquet') }}— y DuckDB carga httpfs y apunta el endpoint de S3 a minio:9000. Nada de
esto es un truco. Es la misma configuración que usarías contra un bucket real,
con otra URL.
Hasta acá todo funciona como promete el folleto.
El paso que no entraba
El último incremento fue publicar el producto Gold como tabla Iceberg en un catálogo REST, para tener ACID, time-travel y evolución de esquema. El writer es un script de PyIceberg: lee el parquet de Gold y escribe la tabla.
La pregunta de diseño se responde sola. ¿Dónde va un paso del pipeline? En el orquestador. Para eso está Airflow: es el servicio que ya corre, ya tiene el DAG, ya sabe cuándo se terminó Gold.
Entonces, al Dockerfile de Airflow:
FROM apache/airflow:2.10.4-python3.11
RUN pip install --no-cache-dir "dbt-duckdb>=1.8,<2.0"
RUN pip install --no-cache-dir "pyiceberg[s3fs,pyarrow]>=0.7"   # ← esto
Lo que pasa cuando lo intentás
La imagen apache/airflow:2.10.4-python3.11 trae este juego de versiones:
| Paquete | Airflow trae | Después de instalar PyIceberg |
|---|---|---|
pyarrow | 16.1.0 | 25.0.1 |
botocore | 1.35.36 | 1.43.56 |
aiobotocore | 2.15.2 | 3.9.0 |
aiohttp | 3.10.11 | 3.14.3 |
fsspec | 2024.10.0 | 2026.7.0 |
Nueve majors de pyarrow. Un major de aiobotocore, que es de quien depende
el provider de AWS. fsspec salta dos años.
Y esto es lo que pip dice mientras lo hace:
ERROR: pip's dependency resolver does not currently take into account all the
packages that are installed. This behaviour is the source of the following
dependency conflicts.
boto3 1.35.36 requires botocore<1.36.0,>=1.35.36, but you have botocore
  1.43.56 which is incompatible.
gcsfs 2024.10.0 requires fsspec==2024.10.0, but you have fsspec 2026.7.0
  which is incompatible.
apache-airflow-providers-http 4.13.3 requires aiohttp<3.11.0,>=3.9.2, but you
  have aiohttp 3.14.3 which is incompatible.
Tres restricciones violadas, la palabra ERROR en mayúsculas, y:
$ echo $?
0
Código 0. Éxito. Un RUN pip install en un Dockerfile no distingue entre esto
y una instalación limpia: no hay && que falle, no hay paso en rojo, la imagen
se construye y se publica.
Por qué pip tiene razón
Lo tentador es leer esto como un bug del resolvedor. No lo es. Miré qué declara realmente Airflow:
apache-airflow-providers-amazon 9.1.0
    botocore>=1.34.90
    aiobotocore[boto3]>=2.13.0
    s3fs>=2023.10.0
apache-airflow 2.10.4
    fsspec>=2023.10.0
    aiobotocore>=2.9.0
Todas cotas inferiores. Ninguna cota superior. botocore 1.43.56 satisface
>=1.34.90. aiobotocore 3.9.0 satisface >=2.13.0 — aunque sea un major que
el provider nunca vio. Formalmente, pip resolvió bien. Cumplió cada restricción
que el paquete se molestó en escribir.
Las versiones que de verdad funcionan juntas no están en la metadata. Están en
el constraints file que Airflow publica aparte, por versión y por Python.
Ese archivo es la garantía real, y pip install no lo lee salvo que se lo
pases con --constraint.
Que es exactamente lo que un RUN pip install extra en un Dockerfile heredado
no hace.
Es la misma forma que el problema del que escribí ayer: la garantía existe, está bien hecha, y vive en un mecanismo que en el camino real nadie ejercita.
Lo peor no es que rompa
Después de todo eso, esto sigue andando:
>>> from airflow.providers.amazon.aws.hooks.s3 import S3Hook
>>> # (sin error)
El import funciona. Airflow arranca. La UI levanta. Los DAGs aparecen.
No hay un momento en que el sistema te diga que está roto. Lo que hay es un
provider de AWS corriendo contra un aiobotocore un major por delante del que
se probó, y un provider de HTTP contra un aiohttp cuatro minors adelante de
su techo declarado. Eso no explota al importar. Explota más tarde, en una
llamada puntual, con un TypeError en una firma que cambió, y en un stack
trace que apunta a una librería que vos no instalaste a propósito.
Un fallo al arrancar es un buen fallo: es barato, es inmediato, y te dice qué pasó. Esto es lo contrario.
La salida: dejar de compartir intérprete
El writer de Iceberg terminó como un contenedor propio. Una imagen mínima, sin Airflow adentro:
FROM python:3.11-slim
RUN pip install --no-cache-dir "pyiceberg[s3fs,pyarrow]>=0.7" duckdb requests
Airflow sigue siendo el orquestador —dispara el paso— pero no lo hospeda. La diferencia parece de matiz y es la que hace que el stack se sostenga: cada proceso vuelve a tener su propio espacio de dependencias, que es lo que en la nube tenías gratis.
Es, literalmente, reconstruir a mano el aislamiento que perdiste al bajar todo a una máquina. Docker Compose no está ahí para que sea cómodo levantar el stack. Está ahí para que las piezas no se toquen.
En el camino apareció el otro síntoma del mismo problema, más benigno: DuckDB
lee el catálogo Iceberg con ATTACH ... (TYPE iceberg, AUTHORIZATION_TYPE 'none'). Sin ese parámetro exige OAuth2 contra un catálogo que corre en
localhost sin identidad. El default asume el mundo gestionado; en local hay
que decirle explícitamente que no hay nadie a quien autenticar.
Lo que esto dice del “lakehouse en tu laptop”
Vale la pena separar dos cosas que se venden juntas.
Lo que un lakehouse local sí prueba: el SQL, las transformaciones, el modelo medallion, los tests de dbt, el linaje, la semántica de Iceberg. Todo eso se traslada tal cual. Es mucho, y es la razón por la que el ejercicio vale.
Lo que un lakehouse local prueba de más: un problema de convivencia de dependencias que en producción no vas a tener, porque allá cada pieza es un servicio con su propio runtime.
Y lo que no prueba: volumen, concurrencia, particionado real, costo.
La trampa es creer que el segundo grupo es “ruido de local” y no vale nada. Al revés: es la parte que más rápido te enseña dónde estaban las costuras. Pasás una tarde entendiendo por qué el orquestador no puede hospedar un paso, y salís con una idea mucho más concreta de qué te estaba dando la nube además de máquinas.
Lo que me llevo
- El aislamiento es una feature de la nube, y no está en el diagrama. Cinco servicios gestionados son también cinco resolvedores de dependencias independientes. Al colapsarlos en una máquina, eso se pierde primero.
- Código 0 no quiere decir que salió bien.
pipimprimeERRORy sale exitoso. CualquierRUN pip installen un Dockerfile heredado puede estar pisando pins ajenos en silencio. - Un
>=sin techo no es una garantía, es una intención. Si la versión que funciona vive en un constraints file, el comando que instala tiene que leerlo. Si no, la garantía es decorativa. - Orquestar no es hospedar. Que el orquestador dispare un paso no obliga a que el paso corra dentro de su intérprete. Separarlos cuesta un contenedor y evita una clase entera de problemas.
- Preferí el fallo ruidoso. Que el import siga funcionando después de romper tres restricciones es peor que un crash: te deja creyendo que estás parado sobre algo que ya no está.
Nada de esto es sobre Airflow ni sobre PyIceberg. Es sobre que bajar una arquitectura a una sola máquina no la simplifica: le cambia la topología. Y las cosas que la nube te resolvía sin que te enteraras pasan a ser tuyas, empezando por las que nunca supiste que existían.